





文 | 蓝字计划,作者|Chester
这边宇树上市才一个月,市值就从4400多亿的高点跌到了2000亿出头。而在大洋彼岸,"美国宇树"的机器人开始"成精"了。
9月17日,Figure AI发布新模型Helix 2.5,把机器人带进了30个陌生家庭,让它铺床、叠毛巾、收拾玩具。
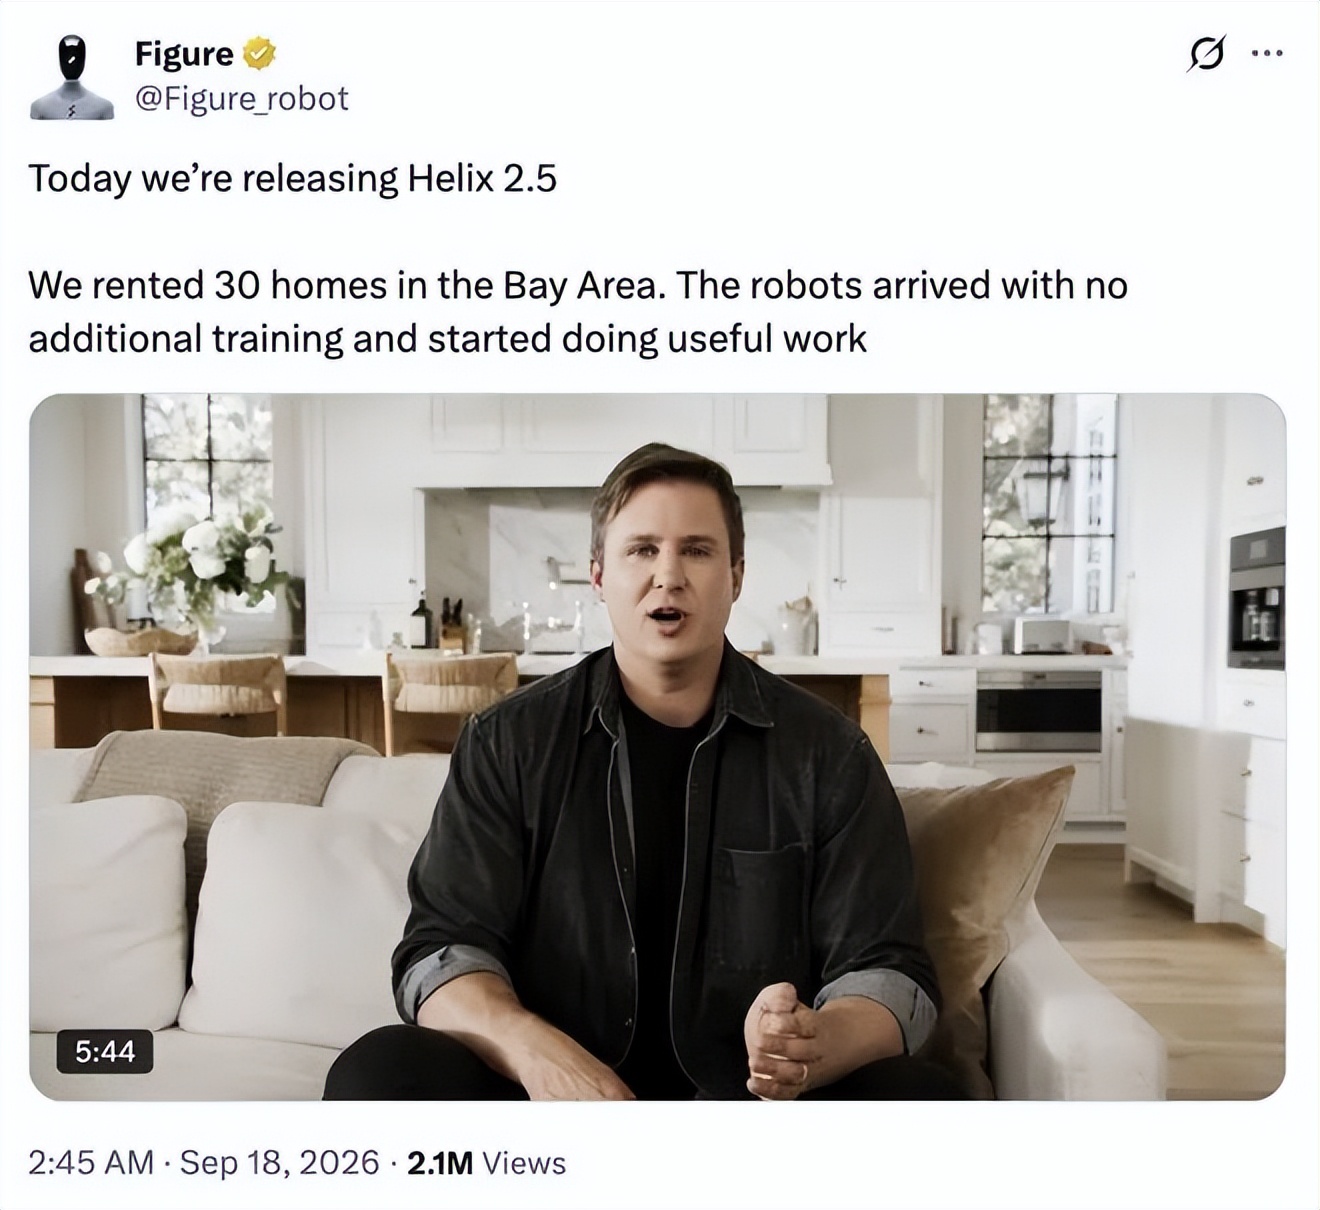
这些活它也不是第一次干。今年3月,Figure的机器人就能自己打扫客厅;5月,它还在桑尼韦尔总部搞了场持续约200小时的直播,3台机器人轮班,一口气分拣了24.9万件快递。
只是这次的新鲜之处,在于Figure的机器人秀了一把"换了地方也能干"。
干过家务的人,总不会到了别人家,就得从头学一次怎么铺床、怎么叠衣服。但机器人换个地方,大概率得让人重新演示、采集数据,再训练一遍,才能在新环境里干活。
甚至只是各家的家具摆放、物品大小不一样,之前学会的动作就可能不管用了。
而Figure AI这次偏偏把机器人扔进了30个此前从未去过的真实家庭,没有提前采集这些家庭的数据,也没有挨家重新训练,就让机器人直接上手干家务,还宣布实现了"零样本泛化",中译中大概就是"机器人到了新地方,不用重新学也能干活"的意思。
难道,机器人保姆马上就要上岗了?
机器人终于学会举一反三?
不过,真把成绩单摊开来看,只看数据的话,这次“泛化”也没有神到哪里去。
Figure一共测试了420次,Helix 2.5成功完成237次,整体成功率为56%。拆开看,铺床成功率67%,叠毛巾62%,收拾玩具只有40%。
也就是说,它每干两次活,差不多要失手一次。尤其是最后一项,十次里有六次都收拾不明白,离真正能接管家务的机器保姆还远着呢。
但56%这个数字,放在人形机器人做家务的泛化测试里,已经算得上顶尖。按照Figure的说法,这是人形机器人第一次在如此多的真实家庭中,展示这种规模的零样本全身泛化。
官方还放了一条3小时57分钟的完整视频。在这条视频里,Helix 2.5还真的展现出了一些非常有“人味”的动作。
比如铺床时,机器人发现自己站的位置不合适,会主动后退,重新调整姿势;被子没有铺好,它还知道绕到床的另一边,换个位置继续整理。以前的机器人经常是动作一旦做偏,后面就傻眼了,甚至还有为了不出乱子直接罢工的。
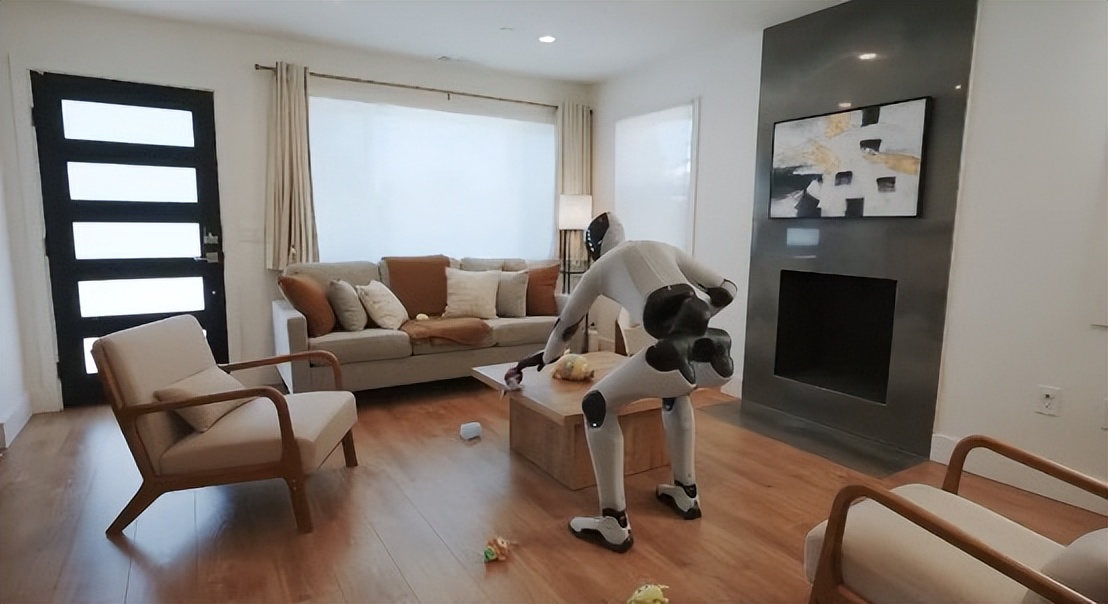
而现在,Helix 2.5最惊喜的就是已经会在干活的过程中发现不对的时候,马上想办法补救。
这时候再回头看今年5月那场200小时直播,两代机器人的差别就很明显了。
当时的Helix 02可以守着分拣台连续干活,但那些本事依赖在工作现场采集的数据。工位一换,周围的设备和物品改变了之后,哪怕是同样的分拣工作,但机器人还是得重新采集数据、重新训练。
最终,虽然那场直播测试证明了Helix 02确实是个可以连续干活的好手,但仍没有证明它真的拥有泛化能力,技能可以随着环境的变化活学活用。
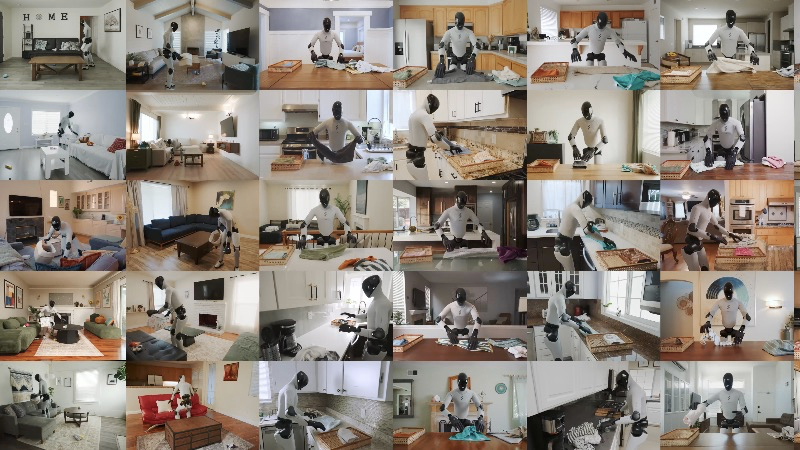
而这次呢?Helix 2.5可是换了足足30个地方。
每个家庭的床、家具和物品都不一样,它依然能完成一半以上的任务。
|那在那么短的时间里,Helix 2.5怎么进步了那么多?
Figure做了一组对照实验,两边使用相同的任务数据,模型架构、训练方法和测试条件也完全一致,唯一的区别,是其中一个模型提前看过一套人类干活的视频。
结果,没看过的成功率只有9%,看过的直接涨到了56%。
那么,这套视频里到底有什么,能让机器人在陌生环境中的表现一下提高这么多?
秘密就叫做Index。
先培训,再上岗
Index这个名字听起来很像某种复杂技术,但真相也许远比你想的要简单。继续中译中,就是Figure花钱请人干活,再把整个过程拍下来,拿去教机器人。
有人在家铺床、叠衣服、打扫卫生,也有人在餐厅收拾桌子,在商店补货,甚至还有人录下了铲猫砂和换机油的过程。只要愿意,普通人下载Index的应用,就可以把自己做事的视频上传给Figure,审核通过后还能拿到白花花美刀。
短短四个月,它就在108个国家积累了超过1600万条视频,每周还有4.4万人持续上传。Figure已经为此支付了1500万美元。
不过也不是随便拍一条扫地的视频上传上去就能美滋滋拿钱了。这些上传了又经过审核的视频,都有个大前提:不重样。
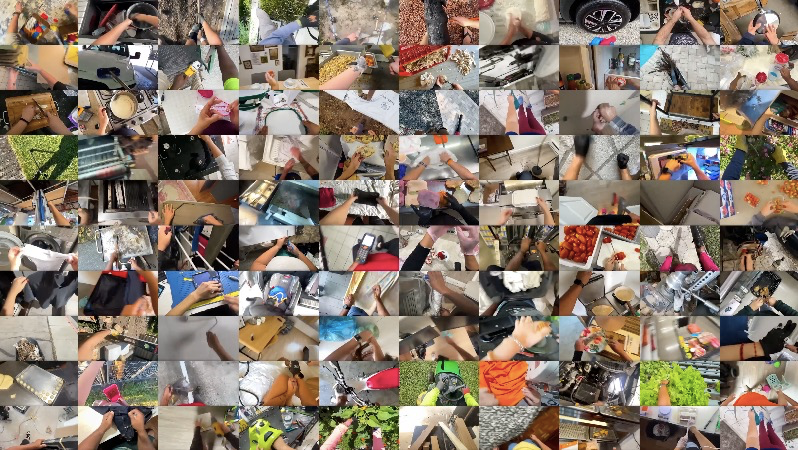
Figure会把上传的内容筛选、去重,再检查有没有作弊和大量重复。按照公司公布的数据,每1000小时的Index视频,大约涉及373种任务、1146种物品和116种环境。
最终在Index上,同样是铺床,有人从床头开始,有人先抖开被子;同样是整理房间,每家摆放的家具、需要收拾的东西也不一样。同一个类型的任务却有着五花八门的解法,主打一个“贵在真实”。
而且这些同一个任务的不同变化,都是自然产生的,再厉害的工程师也不可能坐在实验室里,一条条模拟、设计出来。
于是,Figure的机器人真正开始练习之前,就已经通过看大量人类怎么跟现实世界打交道的真实视频,先培训再上岗。
有了这些视频打底,Figure就可以先把训练的顺序整个调了过来。
过去,机器人通常是先确定要学什么,再围绕这项任务收集数据:教叠毛巾,就安排机器人反复叠毛巾。
现在Helix 2.5反着来,先在Index里预训练,见过足够多的人、物品和环境,再去学铺床、叠毛巾和收拾玩具。
这套思路,和大模型的预训练是一个道理:先海量"见世面",再专门学手艺。
前面的对照实验已经证明,这一步确实有用。同样一批家务训练数据,交给一个看过大量人类示范的模型,到了陌生家庭,表现完全是两个样子。
这也解释了Helix 2.5为什么能在30个家庭里临场调整。只要此前见过的动作和场景足够多,遇到床铺尺寸变化、站位不合适或者东西没放好时,它的脑子里就多了几种可以尝试的办法。
不过,既然1600多万条视频已经让Helix 2.5学会了一些举一反三,那么再多一倍、两倍,甚至十倍的数据,它还会不会继续变聪明?
机器人训练变天了?
其实喂的数据越多,大模型的效果越好,这在AI大模型这边,早就是一条金科玉律,也就是Scaling Law。
所以这些年,各大模型公司都在抢着买更多算力、收集更多语料,再把模型规模越做越大。因为按照Scaling Law,只要数据和算力继续增加,模型通常就会按照一定规律变强。
这次Figure给机器人喂了2倍、4倍甚至8倍的Index数据,从操作上看,也有点像是在机器人身上复刻大模型的Scaling Law。
那么,机器人这边也有Scaling Law吗?
你还别说,真给Figure测出来了。
研究人员一共训练了四组模型,最大一组使用的Index数据,是最小一组的8倍。模型大小、后续的家务训练以及其他条件全部保持一致,只改变预训练时给机器人看过多少人类视频,然后只盯一个指标:机器人预测下一步动作的误差。
结果,Figure发现:随着Index数据增加,机器人的动作预测误差还真的一直在下降。而且这条线降得很规整,数据每增加一档,误差会减少多少,已经能够提前估算。
Figure还用前三个模型的数据拟合出这条曲线,在最大那次训练开始之前,直接算出了它的误差。等训练跑完一看,实际结果和预测对到了小数点后四位。
这么看,机器人好像真有自己的Scaling Law。Figure还给这条曲线起了名字:"人类到人形机器人的迁移Scaling Law":
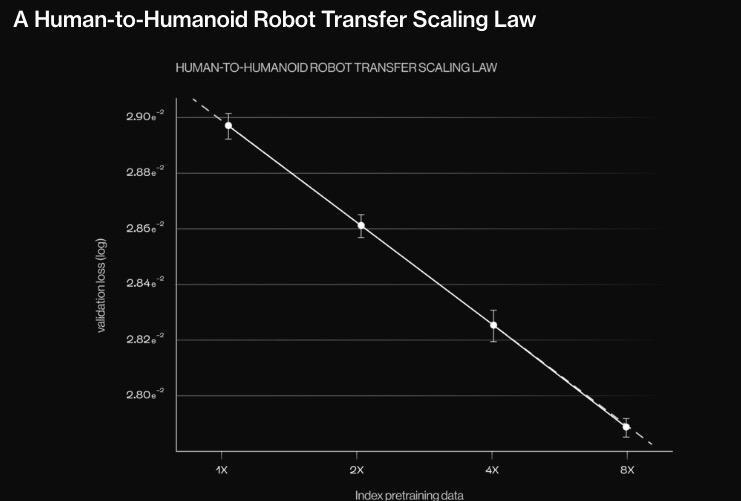
这条曲线,解的是机器人行业的一个老大难:过去想让机器人更强,只能采集更多机器人数据,又贵又慢。
但如果人干活的视频能按可预测的规律变成机器人的本事,投入多少、产出多少,就能照着这条曲线提前算出来,要花多少钱,心里有数。
Figure愿意继续收数据、买算力,赌的就是这条曲线成立。
9月3日,Figure宣布与AI云计算公司Nscale合作,计划从2027年下半年开始部署英伟达Vera Rubin平台,最终最多使用10万块GPU。最初承诺的算力投入达到35亿美元,未来意向是扩大到60亿美元以上。
35亿美元买算力,这更像是大模型公司的做法。而且Nscale不只是卖算力,还战略入股了Figure,成了它的股东。黄仁勋在官宣里也说,这次合作"激活了机器人飞轮"。
另一边,Index每秒钟还在收到大约35分钟的人类行为视频。
一边是全世界的人不断拍下自己怎么干活,另一边是最多10万块GPU等着把这些视频喂给机器人。Figure作为一家机器人公司,却走在一条越来越像大模型公司的路上。
不过,目前这条被称为"人类到人形机器人的迁移Scaling Law"的曲线,还有挺多问题。它一共只有四个点,跨度只有8倍,撑不起一条定律。
比如实验测的是动作预测的误差,不是任务成功率。误差降了,也不代表喂的数据越多,家务就干得越好。
而且56%的成绩是Figure自己打的分,30个家庭全是湾区租来的房子,三项任务也是提前选好的。
尽管Figure在这次家务测试中迈出了重要一步,但距离大家请到一位机器保姆,还有很远的距离。
参考资料:
APPSO《刚刚,机器人首次「空手闯进」 30个陌生家庭,进门就干活》
极客公园《Figure AI宣称找到了机器人版scaling law,同行却说它其实根本不会泛化》
 快报

根据《网络安全法》实名制要求,请绑定手机号后发表评论